Práce s datasetem iris
Požadavky na absolvování
Otevřené: středa, 1. dubna 2026, 00.00
Termín: pátek, 15. května 2026, 23.59
Pracujte v Pythonu (Jupyter Lab) s datasetem iris. Můžete využít univerzitní server: https://hpc.troja.mff.cuni.cz:8000
Dataset popisuje vzorky tří druhů kosatců (Iris setosa, Iris virginica a Iris versicolor). U každého vzorku byly měřeny celkem čtyři znaky: délka a šířka zvlášť pro vnější a vnitřní okvětní lístky. Údaje jsou v centimetrech.
K anglické terminologii použité v datasetu viz foto:
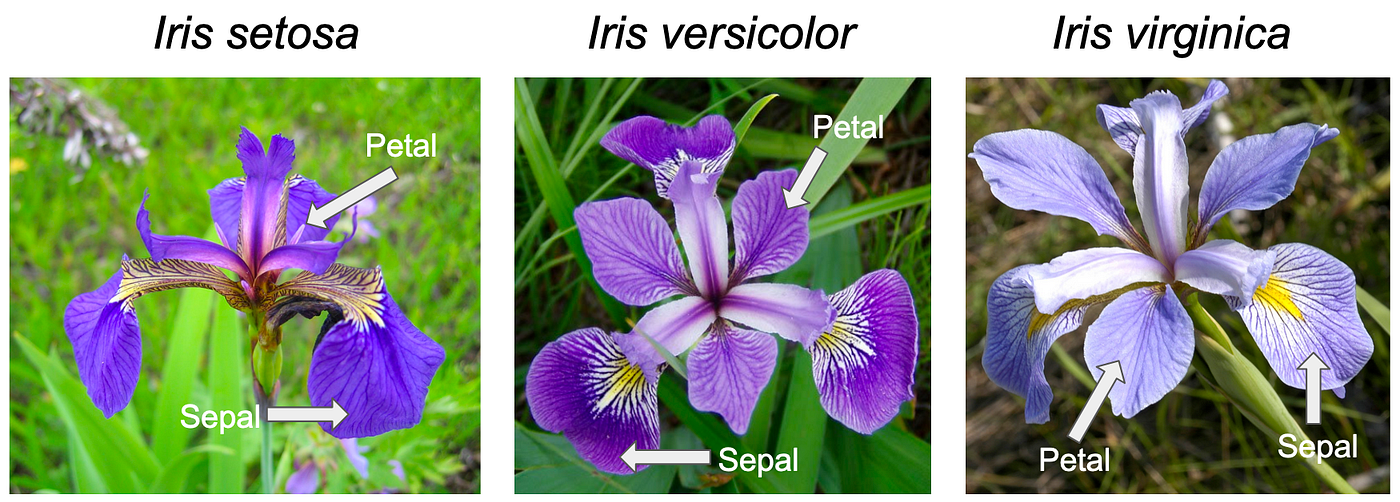
Úkol k datasetu:
- Zjistěte velikost a základní charakteristiku dat.
- Pořiďte alespoň jednu smysluplnou vizualizaci těchto dat.
- V několika větách tuto vizualizaci interpretujte.
Způsob odevzdání:
Svoje zjištění k charakteristice dat, vizualizaci (stačí screenshot) a interpretaci exportujte do dokumentu (např. MS Word/DOCX, PDF,…) a nahrajte do Moodlu.
Doporučený postup:
- Použijte knihovnu scikit-learn, která tento dataset obsahuje. Doporučený způsob načtení do DataFrame je níže.
- Pro zobrazení datasetu použijte knihovnu pandas.
- Pro vizualizaci použijte plotly, nebo jinou knihovnu pro Python.
from typing import Any

import pandas as pd
import plotly.express as px
from sklearn import datasets

# Načtení dat
iris = datasets.load_iris()
df = pd.DataFrame(iris.data, columns=iris.feature_names)
df["species"] = pd.Series([iris.target_names[i] for i in iris.target], dtype=str)
Instalace potřebných knihoven v Jupyter Lab:
%pip install -U scikit-learn plotly
Více info k datasetu: https://en.wikipedia.org/wiki/Iris_flower_data_set).